Hej tam! Jako dostawca produktów Single Row często spotykam się z pytaniami, czy w algorytmach uczenia maszynowego można wykorzystać pojedynczy wiersz. Cóż, przejdźmy od razu do tego tematu i zbadajmy jego tajniki.
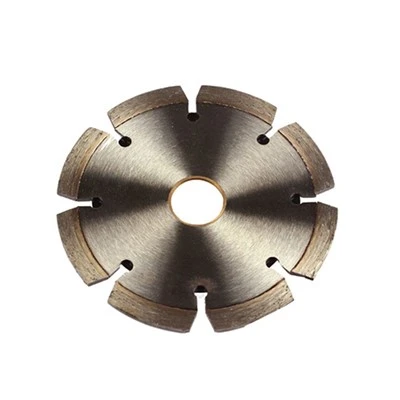
Po pierwsze, czym dokładnie jest pojedynczy wiersz? W kontekście naszych produktów pojedynczy wiersz odnosi się do konkretnej konfiguracji artykułów. Mamy na przykład kilka świetnych produktów, takich jakŚciernica diamentowa 100 mm do ściernego kamienia betonowo-cementowego. Ta jednorzędowa ściernica jest przeznaczona do trudnych prac związanych z betonem, cementem i kamieniem. Jest to narzędzie o wysokiej wydajności, posiadające unikalny jednorzędowy układ segmentów diamentowych, co nadaje mu szczególne właściwości.
Porozmawiajmy teraz o algorytmach uczenia maszynowego. Uczenie maszynowe polega na uczeniu komputerów uczenia się na podstawie danych oraz przewidywania i podejmowania decyzji. Istnieją różne typy algorytmów uczenia maszynowego, takie jak uczenie się nadzorowane, uczenie się bez nadzoru i uczenie się przez wzmacnianie. Każdy typ ma swoje własne wymagania dotyczące wprowadzania danych.
W świecie uczenia maszynowego dane są zwykle organizowane w tabelach lub macierzach. Pojedynczy wiersz w tych tabelach reprezentuje pojedynczą instancję lub obserwację. Na przykład, jeśli tworzysz model uczenia maszynowego w celu przewidywania cen domów, każdy wiersz w zestawie danych może reprezentować inny dom, a kolumny zawierają takie funkcje, jak liczba sypialni, powierzchnia i lokalizacja.
Czy zatem można zastosować pojedynczy wiersz w algorytmach uczenia maszynowego? Odpowiedź brzmi: tak, ale to zależy od sytuacji.
Używanie pojedynczego wiersza do testów wstępnych
Kiedy dopiero zaczynasz opracowywać model uczenia maszynowego, pojedynczy wiersz danych może być naprawdę przydatny do wstępnych testów. Możesz go użyć, aby sprawdzić, czy algorytm działa zgodnie z oczekiwaniami. Załóżmy na przykład, że napisałeś kod prostego algorytmu regresji liniowej. Możesz pobrać pojedynczy wiersz danych ze swojego zbioru danych, wprowadzić go do algorytmu i sprawdzić, czy wynik ma sens. Pomaga to wcześnie wykryć wszelkie oczywiste błędy w kodzie.
Ograniczenia używania pojedynczego wiersza
Jednak użycie tylko jednego wiersza danych ma pewne poważne ograniczenia. Algorytmy uczenia maszynowego są zaprojektowane tak, aby uczyć się wzorców z dużych ilości danych. Pojedynczy wiersz nie dostarcza wystarczającej ilości informacji, aby algorytm mógł nauczyć się znaczących wzorców. Na przykład, jeśli próbujesz przewidzieć ceny akcji za pomocą modelu uczenia maszynowego, pojedynczy wiersz historycznych danych giełdowych nie zapewni algorytmowi wystarczającego kontekstu, aby zrozumieć, jak cena akcji zmienia się w czasie. Aby zidentyfikować trendy, sezonowość i inne wzorce, potrzeba wielu wierszy.

Pojedynczy wiersz w wykrywaniu anomalii
Jednym z obszarów, w którym pojedynczy wiersz może być całkiem przydatny w uczeniu maszynowym, jest wykrywanie anomalii. Algorytmy wykrywania anomalii służą do identyfikowania punktów danych, które znacząco odbiegają od normy. W tym przypadku pojedynczy wiersz może reprezentować nową obserwację. Algorytm porównuje ten pojedynczy wiersz z wzorcami, których nauczył się z dużego zbioru danych. Jeśli pojedynczy wiersz zbytnio odbiega od normalnych wzorców, może zostać oznaczony jako anomalia.
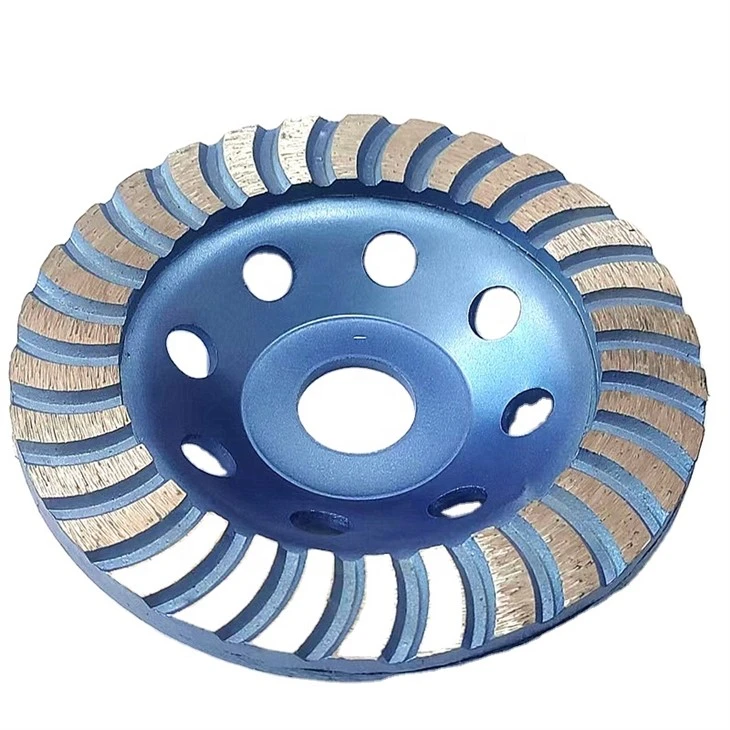
Weźmy inny przykład z naszej oferty produktów, czyliWysokiej jakości ściernica diamentowa garnkowa o średnicy 100 mm z aluminiową podstawą. Załóżmy, że mamy model uczenia maszynowego, który monitoruje wydajność tych ściernic. Każdy wiersz w zestawie danych może zawierać informacje o czasie użytkowania ściernicy, stopniu zużycia i jakości zadania szlifowania. Jeśli nowy pojedynczy rząd zostanie dostarczony w krótkim czasie i charakteryzuje się wyjątkowo dużym zużyciem i bardzo słabą jakością szlifowania, algorytm wykrywania anomalii może oznaczyć to jako potencjalny problem.
Włączanie pojedynczych wierszy do uczenia się w czasie rzeczywistym
W aplikacjach uczenia maszynowego czasu rzeczywistego stale generowane są pojedyncze wiersze danych. Na przykład w sieci czujników monitorującej warunki środowiskowe każdy czujnik wysyła w regularnych odstępach pojedynczy wiersz danych (takich jak temperatura, wilgotność i ciśnienie powietrza). Algorytmy uczenia maszynowego można zaprojektować tak, aby stale aktualizowały swoje modele w miarę nadejścia nowych pojedynczych wierszy danych. Nazywa się to uczeniem się online lub uczeniem przyrostowym.
Nasze produkty jednorzędowe w szerszej perspektywie
Jako dostawca produktów jednorzędowych rozumiemy znaczenie jakości i wydajności. Nasze produkty, takie jakNowy typ 4-calowe tarcze diamentowe do cięcia na zimno do granitu, zostały zaprojektowane tak, aby spełniać najwyższe standardy. A jeśli chodzi o dane związane z tymi produktami, możemy zastanowić się, w jaki sposób można zastosować uczenie maszynowe.
Możemy na przykład wykorzystać uczenie maszynowe do przewidywania żywotności naszych ściernic na podstawie danych z różnych pojedynczych rzędów. Każdy wiersz może zawierać informacje o rodzaju mielonego materiału, prędkości roboczej i zastosowanym ciśnieniu. Analizując dużą liczbę tych pojedynczych rzędów, możemy zbudować model, który pomoże nam i naszym klientom podejmować lepsze decyzje dotyczące terminu wymiany kół.
Podsumowanie i wezwanie do działania
Podsumowując, chociaż pojedynczy wiersz może być używany w algorytmach uczenia maszynowego w pewnych sytuacjach, takich jak wstępne testowanie, wykrywanie anomalii i uczenie się w czasie rzeczywistym, ma on swoje ograniczenia. Jednak w połączeniu z dużym zbiorem danych może przyczynić się do zbudowania wydajnych modeli uczenia maszynowego.
Jeśli interesują Cię nasze produkty jednorzędowe lub masz pytania dotyczące zastosowania uczenia maszynowego do Twoich konkretnych potrzeb związanych z tymi produktami, chętnie się z Tobą skontaktuję. Niezależnie od tego, czy jesteś producentem poszukującym wysokiej jakości ściernic, czy badaczem danych zainteresowanym odkrywaniem nowych zastosowań uczenia maszynowego, jesteśmy tu, aby Ci pomóc. Skontaktuj się z nami, aby uzyskać więcej informacji i rozpocząć rozmowę na temat swoich potrzeb zakupowych.
Referencje
- Mitchell,TM (1997). Uczenie maszynowe. McGraw-Wzgórze.
- Hastie, T., Tibshirani, R. i Friedman, J. (2009). Elementy uczenia się statystycznego: eksploracja danych, wnioskowanie i przewidywanie. Skoczek.